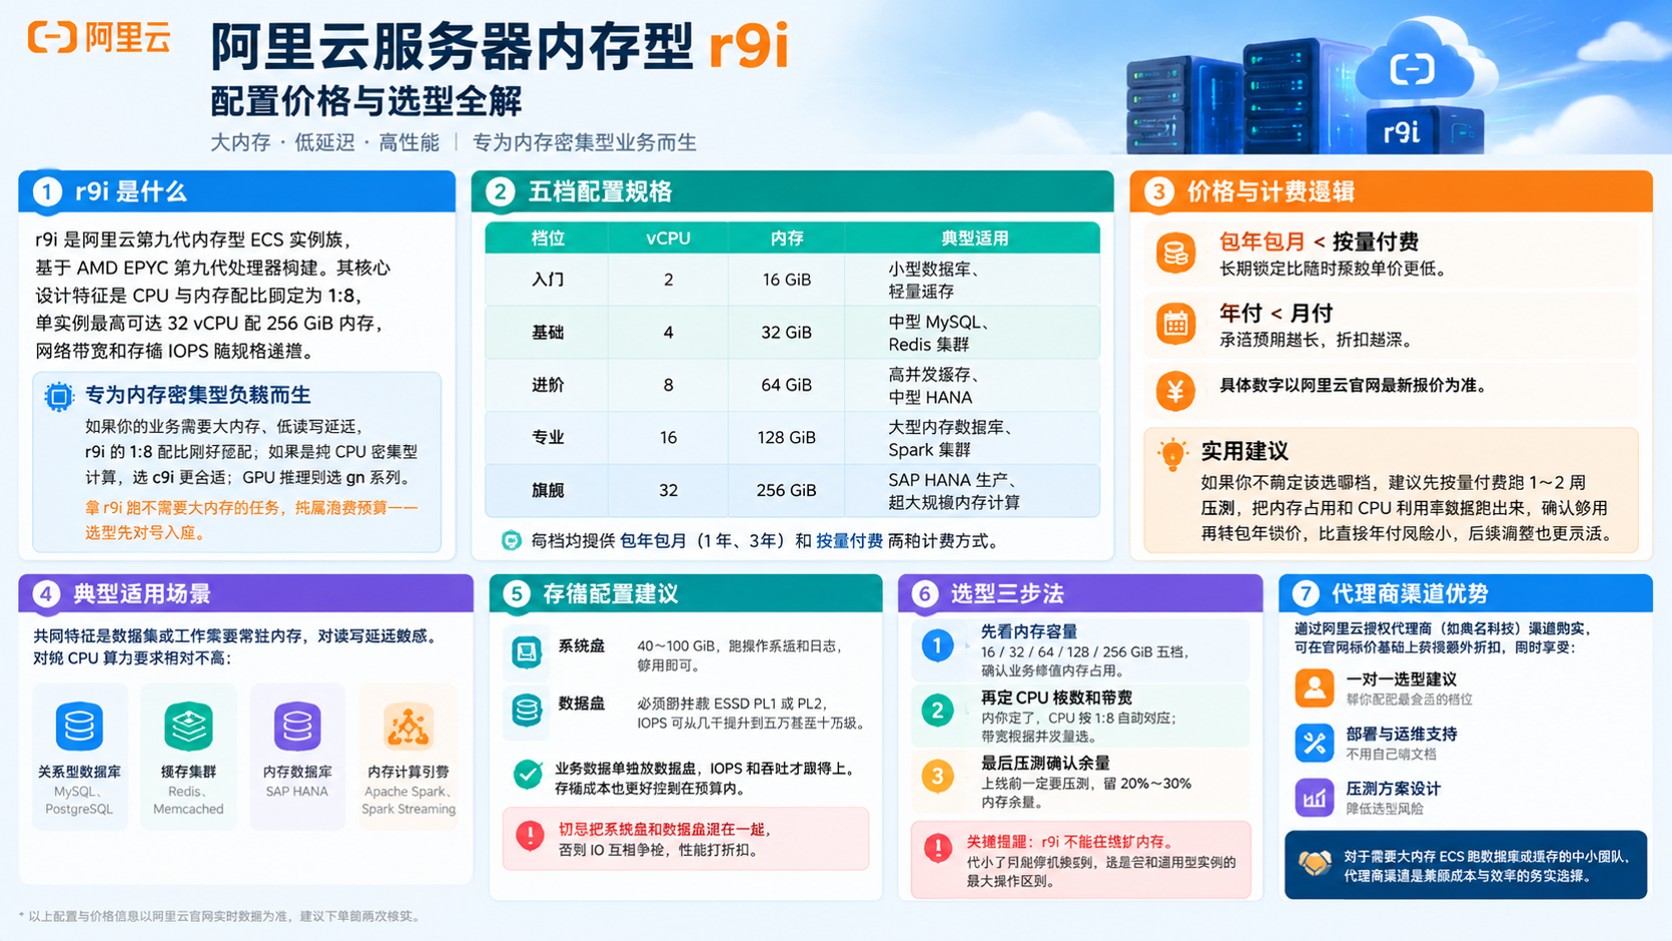
阿里云如何购买大模型机子的设备?
更新时间: 2026-03-05 10:01:54作者: 网站编辑阅读量: 88
为什么你的AI训练总超预算?
“阿里云如何购买大模型机子的设备”背后反映的是算力与成本失衡的本质问题。当前主流厂商均提供专门针对深度学习的大规模计算实例——阿里云g8a/g9a系列(NVIDIA A100/H100)、华为云G9e系列(A10)、腾讯云TG3/TG4(V100/A10)。但多数企业误判业务负载规模后导致资源浪费:某医疗影像公司初期选择g8a起步,在未预估到迭代周期后改用混合部署方案(g8a+本地GPU集群),最终节省65%费用。关键在于——你的数据量级是否匹配PetaFLOPS级算力?

大模型设备能省多少成本?
这是中小企业最关心的问题。“长期用哪个划算?”的答案取决于业务生命周期与计费模式组合。阿里云预留实例券最高可省75%费用(需锁定2-3年),但突发性需求更适配按量付费或竞价实例;AWS Savings Plans类似但支持跨区域共享;华为云推出专属优化型包年包月方案(需承诺最低使用量)。某电商推荐系统团队通过混合计费策略(75%预留+25%竞价),年度成本降低42%,同时保障双十一大促弹性扩容能力。
支持国产芯片的大模型设备怎么选?
信创项目必问!目前主流平台已实现ARM架构覆盖:阿里云倚天710芯片实测推理性能达x86同代产品85%,能耗比提升45%;华为鲲鹏920搭配昇腾Atlas 300I卡可支撑千亿参数微调;腾讯星脉网络专为国产化分布式训练优化。某金融风控实验室在倚天710与昇腾平台间做对比测试时发现:非图神经网络类任务中ARM版吞吐量略逊于x86架构5%,但综合TCO优势显著——前提是你的框架已完成适配验证。
跨平台迁移大模型数据难吗?
“上云会停机吗?”是企业最敏感的问题之一。当前主流厂商均提供零停机迁移方案:阿里云DTS支持TB级向量化数据库秒级切换;AWS DataSync+Snowball组合可处理PB级离线迁移;华为ROMA平台实现API层无缝对接不同架构算力池。某自动驾驶团队通过混合部署策略(保留本地NVIDIA DGX+扩展阿里百炼服务),利用对象存储服务OSS作为统一数据湖,在两周内完成从旧集群到新架构的数据平滑过渡——核心是提前规划好存储分层策略与版本控制机制。
下一步行动指南
如果你也在纠结“阿里云如何购买大模型机子的设备”,建议遵循三步走策略:
1. 明确需求边界:记录过去3个月CPU/GPU峰值利用率曲线
2. 构建多维测试集:在2-3家主流平台创建相同规模镜像环境
3. 设计弹性阈值:用标签体系区分训练/推理负载优先级
。